
Umi-OCR:离线免费的批量截图识字工具
Windows 软件 国内可用离线开源批量 OCR 工具
工具介绍
Umi-OCR 是一款开源的 Windows 桌面 OCR 工具,内置本地识别引擎,截图、贴图、批量图片、PDF 识别收进一个免安装的绿色软件里。它的卖点朴素但击中要害:识别在本地完成,不联网、没有次数额度、不按张计费。
离线本地,量大无负担。 引擎随软件装在本机,识别不经过在线服务,几百张截图挂队列过夜跑也不受额度约束。对要批量处理扫描件、漫画、录屏字幕的用户,这是它与在线识别拉开差距的地方。
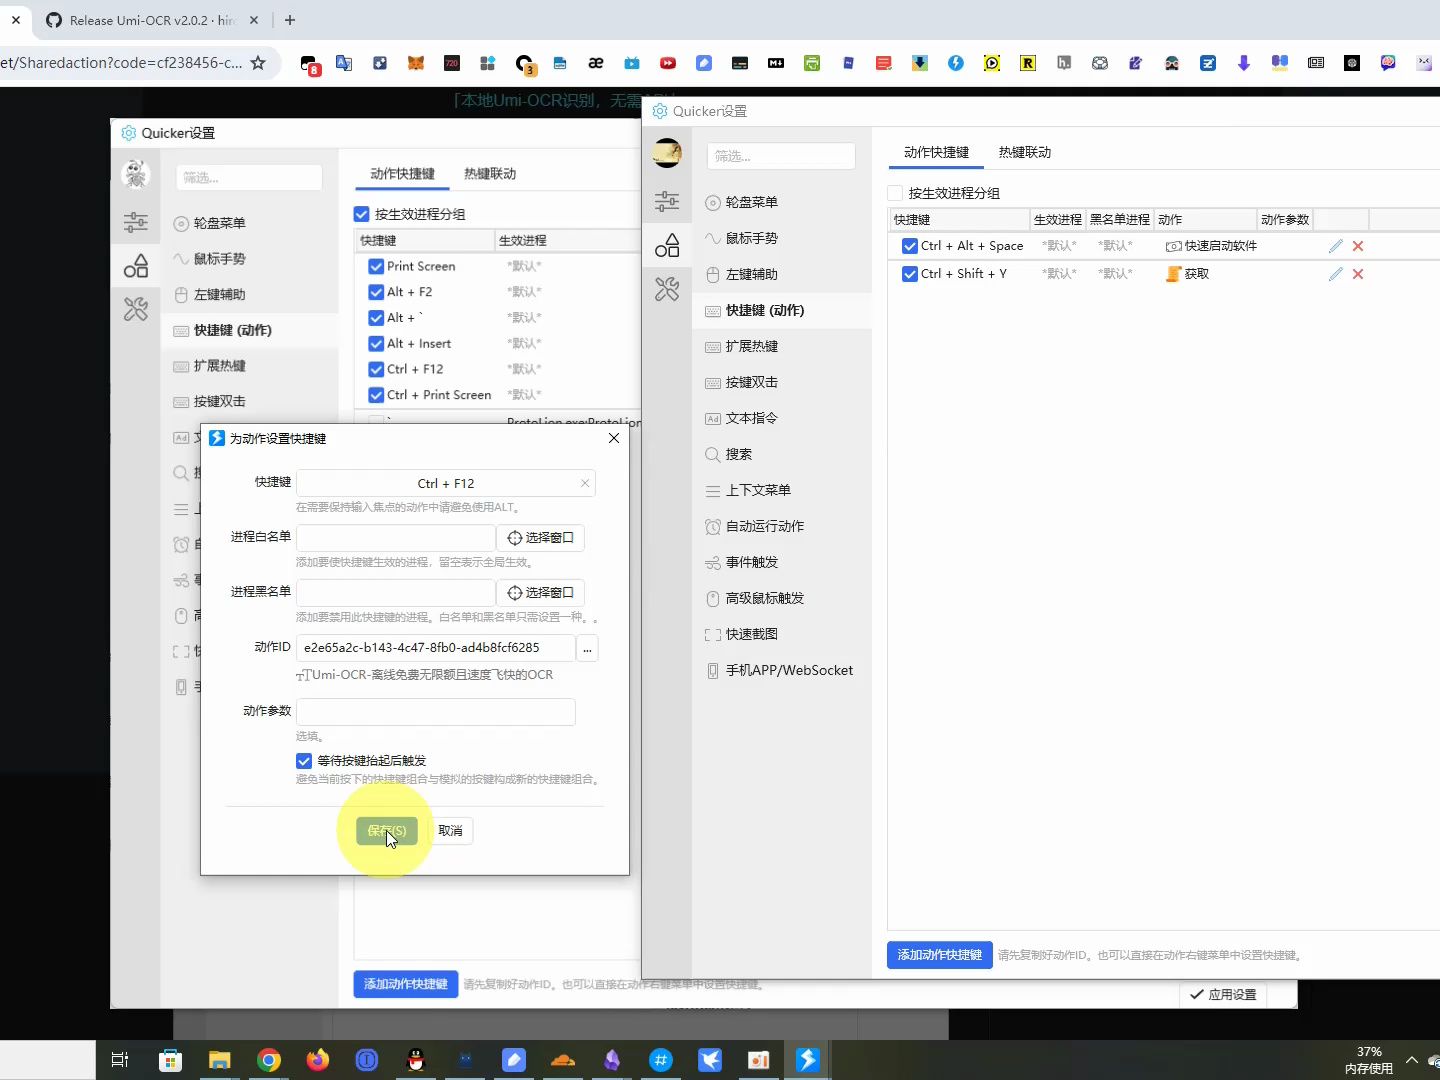
截图贴图,指哪识哪。 快捷键一按框选屏幕任意区域,文字直接进剪贴板;「贴图」模式把识别结果钉在屏幕上对照抄录,查文献、抄代码、录数据都顺手。
批量队列与 PDF。 拖入整个文件夹按队列识别,支持忽略区域与按版面输出;PDF 识别能抽取扫描件的文字层,输出可检索的文档。
留了调用口子。 图形界面之外提供命令行与本地 HTTP 接口,其他程序、脚本可以把识别请求发过来,想把识别能力嵌进自己的工作流也有路可走。
开源绿色,便携即用。 解压即用、不写注册表,配置随身带走;界面原生简体中文,项目在 GitHub 持续开源。
适合谁:需要批量识别图片文字、又不愿把资料上传在线服务的用户;做笔记摘录与数据录入的学生、文员;处理敏感截图、关注隐私的办公场景。
上手三步:GitHub 发布页下载对应显卡或 CPU 版本,解压运行;先截图识别一张,确认引擎与精度档位;批量任务把文件夹拖进队列,设好输出格式开跑。
边界也要说清:只有 Windows 版,Mac 与 Linux 用户要另寻方案;手写体、艺术字、复杂表格的识别率明显低于印刷体,版面还原达不到排版级;低配机器跑高精度引擎会慢,批量任务前先用几张样张试参数;二维码、公式等部分功能属实验性,用前看文档说明。项目仓库国内访问整体可用。
惊蛰 整理 · 2026-10 收录
评测视频
点击跳转 B 站观看原视频已聚合 1 条评测视频 ·1 位博主独立评测
本页由编辑 惊蛰 整理与维护 · 了解幕后